
Прошло более 20 лет с тех пор, как данные со всех сайтов, доступных в сети, стали архивироваться и храниться в открытом доступе в качестве общественного достояния. Веб-архив сайтов позволяет путешествовать во времени и видеть, какой контент размещался на сайтах в разные периоды. Эта информация не только необходима для работы, но и интересна. Допустим, вы хотите узнать, как выглядели Google или Facebook в первые дни своего существования. Или вы хотите узнать, что писали на темы экономики, политики и спорта, а также как жизнь отражалась на фотографиях в прошлом веке. Рекомендуем прочитать эту статью. Ресурс Cityhost.ua рассказал как определять историю сайтов из веб-архива, искать статьи или темы, объяснил суть проекта.
История Wayback Machine
В конце 1990-х годов Брюстер Кейл и Брюс Джиллиат задумались о проблеме сохранения цифрового контента, размещенного на веб-сайтах. Ранее, если владелец веб-ресурса не имел возможности оплатить домен или просто не был заинтересован в дальнейшей поддержке сайта, все размещенные на нем материалы просто исчезали. В 2001 году они создали Internet Archive для архивирования Интернета. К 2020 году в веб-архиве сайтов было собрано 70 петабайт данных (1024 терабайта в петабайте). В настоящее время на его специальных серверах размещено 625 миллиардов веб-страниц.
Для чего вы можете использовать веб-архив?
Этот интересный инструмент нужен в первую очередь тем, кто работает с сайтами. Поисковый робот веб-архива периодически посещает страницы веб-ресурса и сохраняет все материалы сайта. Количество браузеров, просканированных Wayback Machine, напрямую не связано с обновлениями сайта, а зависит от его собственного графика.
Ниже мы представляем полезные аспекты архива.
1. При покупке домена
Зарегистрировав домен, вы не будете знать, новый он или уже кем-то использован. И только в веб-архиве есть возможность проверить его историю, показать, было ли в нем что-то размещено ранее. Эта информация важна по нескольким причинам. Google «любит» старые домены и в этом смысле их легче продвигать, чем новые. Если у вас есть ранее использовавшийся веб-адрес, то эту ситуацию можно использовать по максимуму для продвижения сайта. Но у этого домена, ранее имевшего других владельцев, могут быть и «темные» стороны. Поэтому важно знать не то, как давно был создан домен, а что именно на нем размещалось. Часто веб-разработчики специально ищут дроп-домены (с историей), чтобы быстрее продвигать сайт. Перед регистрацией такого адреса проверяются разные нюансы, в частности, история сайта.
2. Для сотрудничества
При разработке ссылочного профиля создатели линков (линкбилдеры) договариваются с различными сайтами о размещении ссылок на их сайты. Часто это работает как обмен ссылками. Большое значение имеет репутация веб-ресурса, с которым планируется сотрудничество. Для этого проверяется его ссылочный профиль, органический трафик, возраст домена и история сайта. Самое главное, приветствуется сотрудничество со старыми сайтами, которые много лет находятся в одном и том же месте. Ссылки от таких доноров считаются Google качественными. И наоборот, ссылки, размещенные на сайтах с сомнительной историей, могут только навредить отраженному в ссылке профилю.
3. Чтобы найти удаленный контент
Даже если контент будет удален с сайта, есть вероятность, что его можно будет восстановить из веб-архива. Причины такой необходимости могут быть разными — от поиска случайно удаленного контента на своем сайте (хотя создание резервных копий в таком случае — лучший способ) до статей на других сайтах, которые могут понадобиться для подтверждения раскрытия информации (например, нужно доказать, что новость была опубликована). Таким образом можно полностью восстановить не только отдельную страницу, но и весь сайт.
4. Для изучения истории развития ИТ
Программистам, веб-дизайнерам, копирайтерам, иллюстраторам сайтов необходимо понимать, как менялся и развивался Интернет и отдельные веб-ресурсы. Wayback Machine — это неисчерпаемый ресурс для изучения веб-сайтов с живыми примерами за многие годы. Это позволяет, как бы, сесть в машину времени и увидеть все своими глазами.
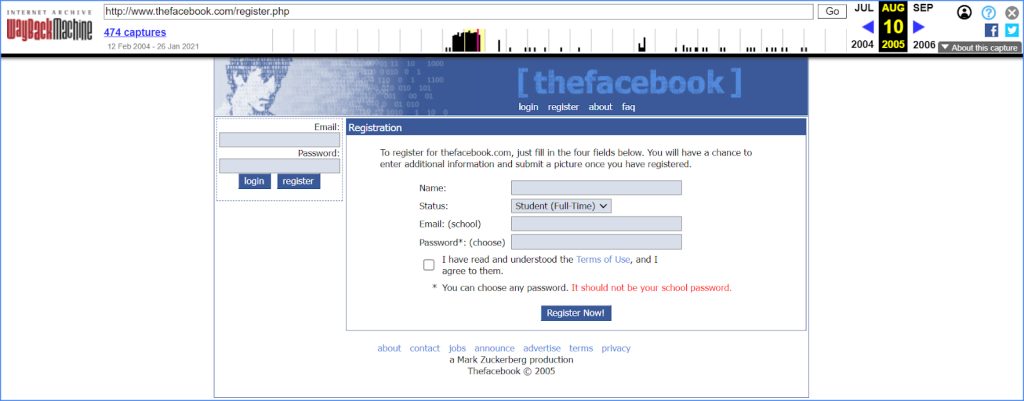
Например, с помощью веб-архива мы можем увидеть, как Facebook выглядел в 2005 году, когда он считался студенческой сетью, и мы можем проанализировать путь, который он прошел, чтобы стать бизнесом на миллиард долларов. Также интересно: веб-архив показывает, что еще в 2005 году сайт в домене facebook.com предлагал купить программное обеспечение AboutFace, чтобы помочь компаниям создавать телефонные справочники сотрудников. Главной особенностью таких электронных справочников было то, что они содержали не только контакты, но и фотографии людей. Как видите, в этом проекте уже есть черты будущей социальной сети.
Wayback Machine — как пользоваться архивом сайта?
Вам нужно ввести адрес сайта в поисковую строку на сайте веб-архива, и сервис покажет всю статистику.
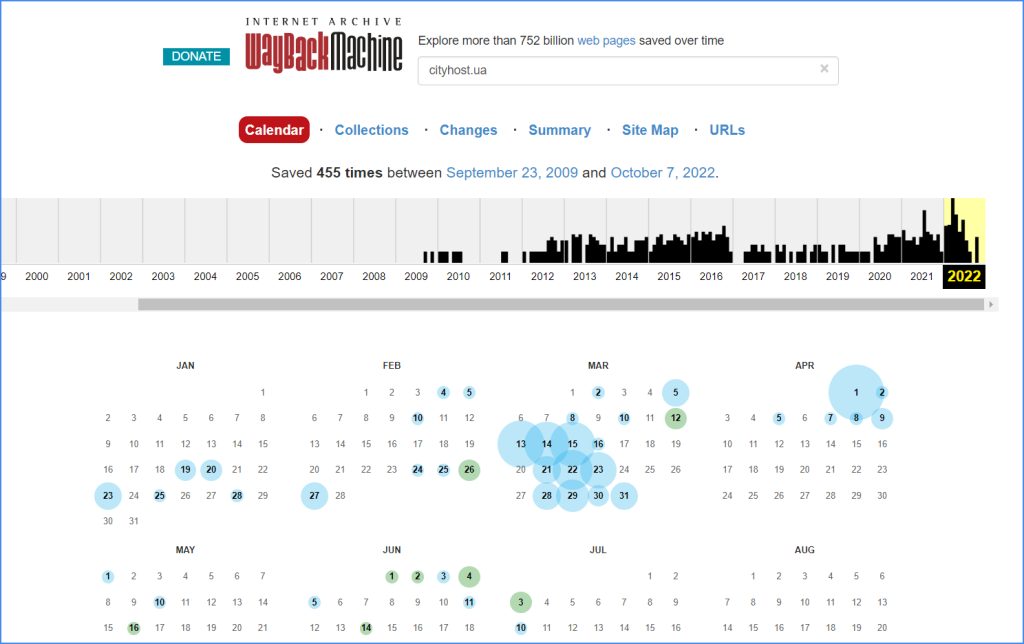
На приведенном выше графике показана активность браузера в зависимости от количества снимков.
Ниже находится календарь, в котором размещены эти снимки. Статус сайта можно увидеть по датам, отмеченным синими и зелеными кружками. То есть в эти дни в интернет-архиве будут храниться фотографии сайта. Если выбрать одну из фотографий и нажать на нее, откроется соответствующая версия сайта.
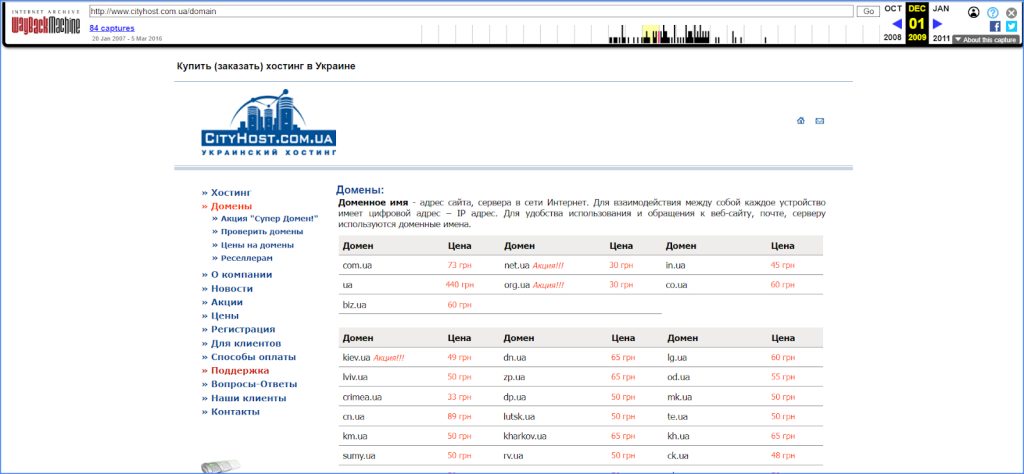
Все ссылки меню в исторической версии работают, поэтому вы можете увидеть все разделы сайта. Вот, например, вид Cityhost.ua в 2009 году. Помимо доменного имени, вы также можете выполнять поиск по ключевым словам, что позволит загрузить список сайтов, продвигаемых по этому ключевому слову.
Другие разделы Интернет-архива
Команда Internet Archive решила сохранить в цифровом виде не только веб-сайты, но и то, что они называют «культурными артефактами». Отдельные файлы, которые содержат этот ценный контент, — это видео, фотографии, тексты и аудио. Веб-архив — это только часть проекта. Кроме того, на сайте Интернет-архива есть еще 5 разделов:
- Тексты
- Видео
- Аудио
- Софт
- Изображения
Интернет-архив содержит множество аудиокниг (в основном на английском языке), радиозаписей, документальных фильмов, газетных архивов, выпусков новостей, художественных фильмов, музыки, старых программ и игр. Например, из «старого сундука» архива нам удалось найти такие уникальные предметы:
- Отчет NASA за 1977 г. (запуски Шаттла и Вояджера)
- Рассказы свидетелей Голодомора 1932-1933 гг.
- Аудиозапись джазового концерта для радио
- Super Mario 1994 (можно играть прямо на сайте)
Чтобы продемонстрировать разнообразие материалов, хранящихся в Интернет-архиве, мы намеренно отобрали образцы с принципиально разным содержанием. Не все файлы в Интернет-архиве обязательно старые — сейчас архивируется много нового контента, который однажды станет исторической сокровищницей.
Интернет-архив в настоящее время включает (по состоянию на конец 2022 г.):
- 38 миллионов книг и текстов;
- 4 миллиона изображений;
- 790 000 программ;
- 14 миллионов аудиозаписей (в том числе 240 000 живых выступлений);
- 7 миллионов видео (включая 2 миллиона телепрограмм)
Это богатство помогает находить нужную информацию не только ИТ-специалистам, но и работникам любой другой сферы, в частности, аналитикам различных направлений, социологам, журналистам и фактчекерам. Многие из этих файлов доступны только в Интернет-архиве, что делает проект уникальной коллекцией цифровых данных.